¿Puede una red aprender a organizar el mecanismo que le permite aprender? Un trabajo del MIT plantea esa pregunta desde la neurociencia computacional. Publicado en línea por PNAS el 9 de octubre de 2026 y difundido por MIT News el día 13, describe cómo pequeñas estructuras pueden emerger de conexiones inicialmente aleatorias y combinarse en un sistema que aproxima una forma de descenso de gradiente, el procedimiento de optimización utilizado en numerosas redes artificiales.
El artículo reúne a seis autores: los tres primeros firmantes, Qianli Liao, Liu Ziyin y Yulu Gan, más Brian Cheung, Mark T. Harnett y Tomaso Poggio. PNAS identifica a los tres primeros como contribuyentes a partes iguales.
Los autores llaman Self-Assembling Learning a este problema de investigación y Self-Assembling Motif, o SAM, a la estructura elemental que proponen. La aportación está en relacionar reglas locales de cambio entre conexiones con una capacidad de aprendizaje que aparece a escala de toda la red. El estudio ofrece un mecanismo posible y predicciones que pueden investigarse. No demuestra que un cerebro utilice exactamente ese mecanismo.
Una regla cercana y un resultado colectivo
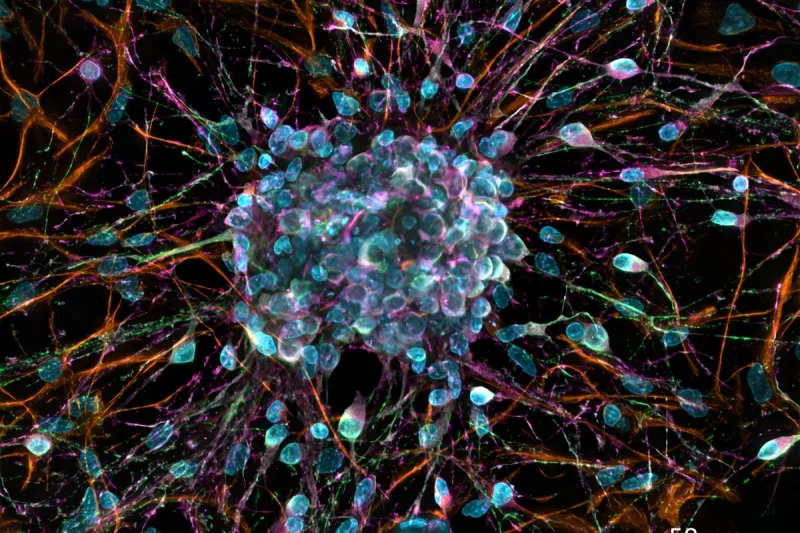
En el modelo descrito por el equipo, varias capas comienzan con unidades conectadas al azar. Cada unidad de una misma capa sigue reglas comunes sobre cómo ajustar sus conexiones. Las interacciones generan estructuras que pueden actuar como componentes de circuitos funcionales. La explicación del Instituto McGovern presenta dos recorridos, uno hacia delante y otro de retorno, enlazados por conexiones cruzadas: ambos se reorganizan hasta que la vía de retorno proporciona señales útiles para entrenar la primera.
La diferencia que se está investigando puede entenderse con una comparación sencilla. Una cosa es entregar a un sistema un circuito ya preparado para corregir errores. Otra es estudiar qué reglas permiten que se forme un circuito capaz de hacer esa corrección. El trabajo se ocupa de esa segunda pregunta, que obliga a explicar tanto el funcionamiento como la organización del mecanismo.
En las tareas de reconocimiento de patrones y clasificación de imágenes descritas por el MIT, la red obtuvo un rendimiento semejante al de redes entrenadas mediante retropropagación. Esa comparación pertenece a los ensayos realizados. No establece que el método sustituya a todos los procedimientos actuales ni que vaya a mejorar automáticamente un asistente conversacional. Para extender una conclusión hay que conocer las tareas, las condiciones y la escala en que se ha comprobado.
La semejanza matemática tiene un alcance concreto
El resumen científico formula un resultado en dos niveles. Primero, el motivo emerge bajo reglas de plasticidad heterosináptica, es decir, reglas que relacionan cambios entre conexiones. Después, las redes construidas jerárquicamente con esos motivos se organizan con dinámicas que aproximan una generalización del descenso de gradiente estocástico. La afirmación conecta la organización local con una estrategia global de optimización.
Esta relación permite hacer una pregunta experimental más precisa que si una red se parece visualmente a un cerebro. Si un mecanismo propuesto explica una función, también debe permitir buscar señales de su presencia y condiciones en las que deja de funcionar. La forma de comprobar una hipótesis importa tanto como su capacidad para producir una clasificación correcta. Un mismo resultado final puede proceder de procesos internos diferentes.
Para la ingeniería, el interés posible está en explorar otras maneras de construir sistemas que se adapten. Para la neurociencia, está en disponer de una hipótesis sobre cómo puede organizarse el aprendizaje. Esos objetivos se apoyan mutuamente, pero exigen evidencias distintas. Un buen resultado en software no basta para establecer una explicación biológica, del mismo modo que una inspiración biológica no garantiza una ventaja práctica en cualquier tarea informática.
El código permite examinar las condiciones
Los autores han publicado el repositorio SAM2026. Incluye un programa de comparación con retropropagación y herramientas para representar la evolución de los experimentos. Su documentación ofrece ejemplos con CIFAR-10 y configuraciones de distinta profundidad. También especifica dependencias como PyTorch, torchvision y NumPy, de modo que el resultado viene acompañado de materiales que otros investigadores pueden inspeccionar.
El propio repositorio introduce una cautela relevante sobre la reproducción. No garantiza resultados idénticos bit a bit entre máquinas o conjuntos de software. Además, indica que una configuración puede divergir antes en una GPU A100 que en la L40S utilizada para el resultado descrito, y reconoce que la causa no está clara. Es una limitación documentada por los autores, no un fallo descubierto en una prueba de esta revista.
Conservar esa información evita presentar una curva experimental como una propiedad incondicional del algoritmo. Si otro equipo estudia el método, necesita registrar el entorno y distinguir la tendencia general de los detalles de una ejecución. Publicar el código facilita ese examen, aunque por sí solo no equivale a una reproducción independiente.
La noticia del 13 de octubre abre, por tanto, una cuestión comprobable: hasta dónde pueden llegar reglas sencillas de reorganización sin que alguien diseñe cada parte del circuito resultante. La respuesta propuesta tiene valor como modelo y como punto de partida para nuevos ensayos. El siguiente paso requiere poner a prueba sus predicciones, sus límites y su estabilidad, conservando la diferencia entre lo observado en una simulación y lo que sucede en las conexiones de un organismo.